一个提示词几乎说明不了什么。下面是真实的测试应该是什么样。
没有人会问 AI 助手“按相关度列出 X 类别下的所有企业”。真实的买家是像问一位懂行的朋友那样提问:“5 人团队最好的项目管理工具是什么”“能推荐一个奥斯汀好的匹克球俱乐部吗”“我附近评价最高的狗狗美容店有哪些”。这些问题简短、口语化、围绕具体情境,而且至关重要的是,它们从不提具体的品牌名,因为买家还不知道该问哪个品牌。这正是这类问题的意义所在:是发现,不是确认。
这一点很重要,因为这与把你自己的品牌名输入 ChatGPT 然后问“介绍一下 Acme Co.”是根本不同的测试。那个问题只是测试模型知不知道你是谁。它并不测试模型在没有提示的情况下会不会点你的名,而这才是真正关系到获取新客户的唯一场景。
AI 模型在设计上就是非确定性的,同一个问题问两次可能得到两个不同的回答,有时点名的品牌也不同,即使其他条件都没变。如果你只用一个提示词测试并得到一个好结果,你只知道模型有一次点了你的名。如果得到一个差结果,你只知道它有一次没点。这两种都说明不了真实的买家群体提出真实的问题分布时会看到什么。
同样的意图,表述方式也确实有差异。赶时间的人会输入“best pickleball club austin”。更慎重的人会写“我在找奥斯汀的匹克球俱乐部,有哪些值得考虑?”。货比三家的人会问“如果是你,会选哪个匹克球俱乐部,为什么?”。这些是同一种购买意图换了不同的措辞,而一个品牌可能在某种表述下出现,在另一种下不出现,取决于模型针对那种具体问法如何检索和权衡信息。
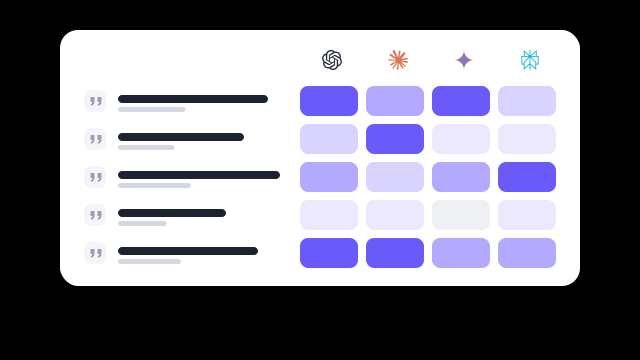
这正是 Mentioned 不只运行一个提示词的原因。当你输入品牌和品类时,它会让 Claude 为该品类生成 5 个真实的买家问题,用真人搜索的方式表述,绝不包含你的品牌名,让测试保持自然而不是带有引导,然后把这 5 个问题分别、并行地发送给每个模型(免费检查用 Claude、ChatGPT 和 Gemini)。它们之间没有共享上下文;每个都是全新的对话,就像 5 个不同的买家各自提出自己的问题。你的得分就是 5 个问题里有几个回答提到了你。它不是加权估计或置信区间,而是对买家可能提问的一系列真实方式中实际发生了什么的如实计数。
如果问题生成因为某种原因失败,Mentioned 会回退到一组固定的中性模板(“最好的{category}有哪些?”“能推荐一个好的{category}吗?”等),而不是跳过检查或随便猜一个结果,详见方法说明页的完整说明。
要为你自己的品类起草一组问题,免费的买家问题生成器会按意图来写:候选名单、先说问题、切换、评估和集成。
实用的结论是:如果你想了解自己的 AI 可见度,不要只用一个提示词测试就把结果当作定论,无论结果好坏。多问几个真实的变体,预期它们之间会有一些差异,看规律而不是任何单个答案。这比一个碰巧幸运(或不幸)的提示词所能给出的,更诚实地反映了买家实际看到的情况。