学ぶ
GEOの測定
AIアシスタントが実際に尋ねられている購入者の質問(そして回答に出る方法)
1つのプロンプトでは、ほとんど何も分かりません。現実的なテストが実際にどんなものかを紹介します。
1つのプロンプトでは、ほとんど何も分かりません。現実的なテストが実際にどんなものかを紹介します。
AIアシスタントに「カテゴリXのすべての事業を関連度順に並べて」と尋ねる人はいません。本物の購入者は、詳しい友人に聞くように尋ねます。「5人のチームに一番いいプロジェクト管理ツールは?」「オースティンのいいピックルボールクラブを教えてくれる?」「近くで評価の高いトリミングサロンは?」。こうした質問は短く、会話的で、具体的な状況を軸に言い表され、そして決定的に、特定のブランド名を含みません。購入者はまだ、どのブランドについて尋ねればいいか知らないからです。それがこの質問の要点で、確認ではなく発見なのです。
これは、ChatGPTに自分のブランド名を入力して「Acme Coについて教えて」と尋ねるのとは根本的に違うテストなので、重要です。その質問が確かめるのは、モデルがあなたを知っているかどうかだけです。モデルが何も促されずにあなたの名前を挙げたかは確かめられません。新規顧客の獲得で実際に意味があるのは、そちらだけです。
AIモデルは設計上、非決定的です。同じ質問を2回尋ねると、ほかに何も変えていなくても、別の回答が返り、ときには別のブランドの組み合わせが挙がります。1つのプロンプトでテストして良い結果が出たなら、わかったのは、モデルが1回あなたを挙げたことだけです。悪い結果なら、1回挙げなかったことだけです。どちらも、実際の購入者が実際の質問の分布を尋ねたときに何が見えるかについては、ほとんど何も教えてくれません。
同じ意図でも、言い回しには実際に幅があります。急いでいる人は「best pickleball club austin」と入力します。もう少し丁寧な人は「オースティンでピックルボールクラブを探しています。どこを検討すべきですか?」と書きます。比較検討している人は「あなたならどのピックルボールクラブを選び、その理由は?」と尋ねます。これらは同じ購入の意図が別の言葉をまとっているだけで、ある言い回しでは挙がるブランドが、別の言い回しでは挙がらないこともあります。モデルが、その特定の言い回しに合わせて情報をどう取得して重み付けするかによるからです。
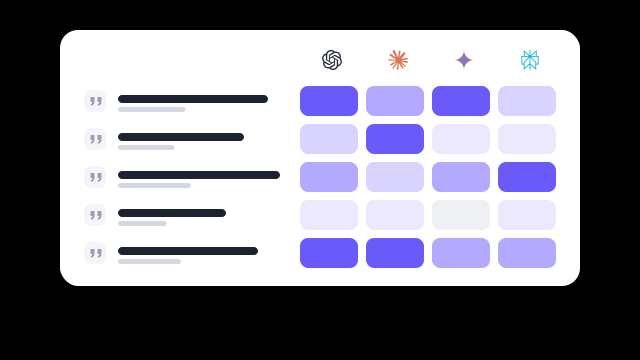
だからこそ、Mentionedは1つのプロンプトを実行するだけではありません。ブランドとカテゴリを入力すると、Claudeにそのカテゴリの現実的な購入者の質問を5つ生成させます。実際の人が検索するような言い回しで、あなたのブランド名は含めないので、誘導のないオーガニックなテストになります。そして5つすべてを、各モデル(無料チェックではClaude、ChatGPT、Gemini)に、独立して並行して送ります。それぞれの間で文脈は共有されず、5人の異なる購入者がそれぞれ自分の質問を尋ねるのと同じように、毎回新しい会話です。スコアは、5つのうち、あなたに触れた回答がいくつ返ってきたか、というだけのものです。重み付けした推定値でも信頼区間でもなく、購入者が尋ねそうな現実的な幅の中で実際に起きたことの、文字どおりの数え上げです。
もし何らかの理由で質問の生成が失敗した場合、Mentionedは、チェックを飛ばしたり結果を推測したりせず、固定された中立的なテンプレート(「おすすめの{category}は?」「いい{category}を教えてもらえますか?」など)に切り替えます。詳しくは方法論のページをご覧ください。
自分のカテゴリで質問のセットを作るには、無料の購入者の質問ジェネレーターが、意図別(候補リスト、課題から、乗り換え、評価、連携)に書き出します。
実践的な結論はこうです。AI可視性を理解しようとするなら、1つのプロンプトでテストして、その結果を(良くても悪くても)最終結論として扱わないでください。現実的な言い換えを複数尋ね、それらの間にばらつきがあることを前提に、1つの回答ではなくパターンを見てください。たまたま運が良かった(または悪かった)1つのプロンプトより、購入者が実際に目にしているものを、はるかに正直に映し出します。