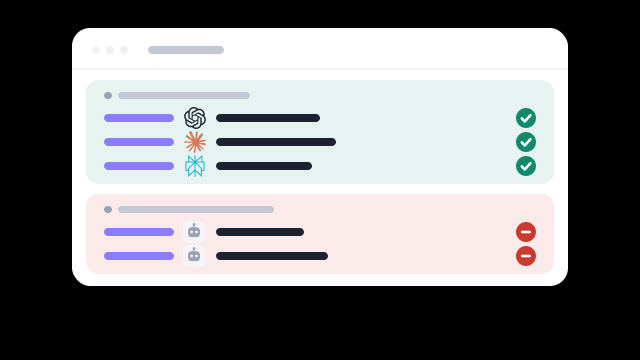
Jawaban singkat. Jika Anda ingin direkomendasikan asisten AI, izinkan crawler pencarian mereka: OAI-SearchBot untuk ChatGPT, Claude-SearchBot untuk Claude, PerplexityBot untuk Perplexity, serta Googlebot dan Bingbot untuk mesin pencari yang menjadi rujukan asisten. Apakah Anda juga mengizinkan crawler pelatihan, seperti GPTBot dan ClaudeBot, adalah pilihan terpisah soal model masa depan. Itu tidak menentukan apakah Anda bisa disitasi hari ini.
Tiga jenis crawler AI
Baca dokumentasi resmi para operator dan crawler terbagi menjadi tiga kelompok.
Crawler pencarian: apakah Anda bisa disitasi
Crawler ini mengindeks halaman agar asisten dapat menemukannya saat mencari di tengah percakapan. OpenAI menyatakan situs yang menolak OAI-SearchBot tidak akan muncul di jawaban pencarian ChatGPT. Anthropic menyatakan menonaktifkan Claude-SearchBot dapat mengurangi visibilitas Anda di hasil pencarian Claude. Perplexity menyatakan PerplexityBot menampilkan dan menautkan situs di jawabannya dan tidak dipakai untuk pelatihan. meta-webindexer milik Meta menjalankan tugas yang sama untuk Meta AI.
Google dan Microsoft tidak menjalankan crawler terpisah untuk ini. Google menyatakan AI Overviews dan AI Mode memakai kontrol yang sama dengan Search, jadi Googlebot yang berperan di sana.
Fetcher pengguna: seseorang memintanya
ChatGPT-User, Claude-User, Perplexity-User, dan MistralAI-User membuka halaman karena seseorang dalam percakapan menanyakannya atau menempelkan tautannya. OpenAI menyatakan aturan robots.txt mungkin tidak berlaku untuk ChatGPT-User, dan Perplexity menyatakan Perplexity-User umumnya mengabaikannya, karena halaman itu diminta oleh seseorang. Anthropic menyatakan crawler-nya, termasuk Claude-User, mematuhi robots.txt.
Crawler dan token pelatihan: model masa depan
GPTBot, ClaudeBot, meta-externalagent, dan CCBot milik Common Crawl mengumpulkan halaman yang mungkin dipakai untuk melatih model. Dua entri di sini sama sekali bukan crawler. Google-Extended mengatur apakah Gemini boleh memakai halaman yang sudah diambil Googlebot, untuk pelatihan dan grounding, dan Google menyatakan itu tidak berpengaruh pada Search. Applebot-Extended mengatur apakah Apple boleh melatih model dari apa yang diambil Applebot.
Apa yang berubah jika masing-masing diblokir
| Jika Anda memblokir | Apa yang berubah |
|---|
OAI-SearchBot | Halaman Anda tidak bisa muncul di jawaban pencarian ChatGPT |
Claude-SearchBot | Pencarian Claude tidak bisa mengindeks halaman Anda |
PerplexityBot | Perplexity tidak bisa menampilkan dan menautkan halaman Anda |
Googlebot | Anda keluar dari Google Search, termasuk AI Overviews dan AI Mode |
GPTBot, ClaudeBot | Konten Anda dikecualikan dari pelatihan di masa depan. Jawaban pencarian langsung tidak terpengaruh |
Google-Extended | Gemini tidak bisa berlatih dari atau men-grounding jawaban pada halaman Anda. Google Search tidak terpengaruh |
CCBot | Halaman baru tidak masuk ke Common Crawl, yang dipakai untuk melatih banyak model |
Dari dokumentasi tiap operator, dibaca 24 Oktober 2026: OpenAI, Anthropic, Perplexity, Google, Meta, Apple, Common Crawl.
robots.txt untuk situs B2B yang ingin disitasi
Ini mengizinkan semua crawler pencarian dan jawaban, menjaga jalur privat Anda tetap privat, dan membuat keputusan soal pelatihan menjadi eksplisit. Hapus grup terakhir jika Anda rela halaman publik Anda dipakai untuk pelatihan.
# Everyone: crawl the public site, not the app
User-agent: *
Disallow: /app/
Disallow: /admin/

# AI search and answer crawlers: same rules, named so nobody
# "tidies" them into a block later
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: meta-webindexer
Disallow: /app/
Disallow: /admin/

# Training: opt out (optional)
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
Disallow: /

Sitemap: https://www.example.com/sitemap.xml
Ada satu aturan yang sering menjebak: crawler hanya mengikuti grup yang menyebut namanya. Jika Anda memberi OAI-SearchBot grupnya sendiri, ia mengabaikan semua yang ada di bawah User-agent: *, jadi jalur privat harus diulang, seperti di atas.
Kesalahan umum
- robots.txt staging di produksi.
User-agent: * / Disallow: / memblokir setiap crawler yang patuh, termasuk crawler pencarian.
- Beranda yang disajikan sebagai robots.txt. Aplikasi satu halaman sering menjawab setiap jalur yang tidak dikenal dengan aplikasinya. Crawler membacanya, tidak menemukan aturan, dan mengizinkan semuanya, termasuk yang ingin Anda blokir.
- robots.txt yang error. RFC 9309 menyatakan crawler yang menerima error server harus menganggap seluruh situs diblokir sampai file berhasil dimuat.
- Memblokir GPTBot untuk “keluar dari ChatGPT”. Itu hanya menolak pelatihan. OAI-SearchBot yang menentukan pencarian ChatGPT.
- Firewall yang memblokir apa yang diizinkan robots.txt. Perlindungan bot di CDN bisa menolak crawler AI sebelum mereka membaca apa pun. Jika robots.txt Anda dijawab dengan 403 untuk crawler, itu kemungkinan penyebabnya.
Pemeriksa crawler AI membaca robots.txt Anda seperti yang diwajibkan RFC bagi crawler dan menampilkan hasilnya untuk 18 crawler, beserta baris yang menentukan tiap hasil.
Bisa di-crawl bukan berarti direkomendasikan
Mengizinkan crawler pencarian masuk membuat Anda memenuhi syarat untuk disitasi. Itu tidak membuat asisten memilih Anda saat pembeli meminta daftar pendek. Hal itu bergantung pada apa yang sudah diketahui model tentang kategori Anda, sumber mana yang dipercayanya, dan apakah halaman Anda menjawab pertanyaan yang diajukan. Langkah berikutnya adalah mencari tahu apa yang dikatakan ChatGPT, Claude, dan Gemini hari ini. Lihat panduan agar disebut untuk apa yang menggerakkannya.
Pertanyaan
Haruskah perusahaan B2B memblokir crawler AI?
Biasanya jangan crawler pencariannya. OAI-SearchBot, Claude-SearchBot, dan PerplexityBot menentukan apakah asisten itu bisa menemukan dan mensitasi halaman Anda saat mencari. Memblokir crawler pelatihan seperti GPTBot dan ClaudeBot adalah keputusan terpisah soal apakah konten Anda dipakai melatih model masa depan, dan itu tidak mengeluarkan Anda dari jawaban langsung.
Apakah memblokir Google-Extended menghapus saya dari AI Overviews?
Tidak. Google menyatakan Google-Extended tidak memengaruhi Google Search, dan AI Overviews serta AI Mode adalah bagian dari Search. Keduanya mengikuti aturan robots.txt Googlebot serta kontrol noindex dan nosnippet.
Berapa lama perubahan robots.txt berlaku?
Tergantung operatornya. Meta menyatakan crawler-nya dapat menyimpan cache robots.txt hingga 24 jam, Amazon menyebut sekitar 24 jam, dan DuckDuckGo menyebut 72 jam untuk DuckAssistBot. Siapkan waktu beberapa hari.
Apakah robots.txt cukup untuk memblokir crawler?
Untuk crawler yang mengikutinya, ya. Ini permintaan, bukan gembok: beberapa fetcher yang dipicu pengguna menyatakan mungkin tidak mengikutinya, dan apa pun yang mengabaikan standar ini tidak terhenti olehnya. Aturan firewall dan CDN adalah alat untuk penegakan.
Jalankan pemeriksaan gratis Periksa robots.txt Anda →