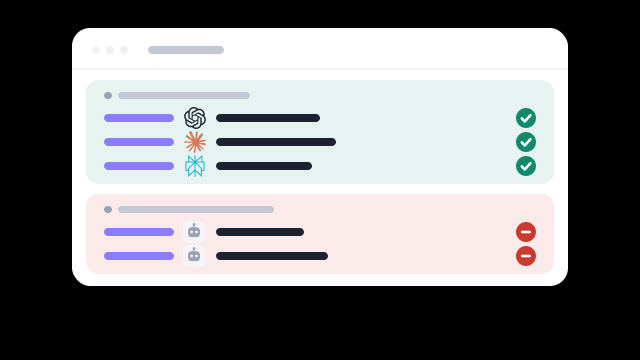
La respuesta corta. Si quieres que los asistentes de IA te recomienden, permite sus crawlers de búsqueda: OAI-SearchBot para ChatGPT, Claude-SearchBot para Claude, PerplexityBot para Perplexity, y Googlebot y Bingbot para los buscadores en los que se apoyan los asistentes. Si además permites los crawlers de entrenamiento, como GPTBot y ClaudeBot, es una decisión aparte sobre los modelos futuros. No decide si te pueden citar hoy.
Tres tipos de crawler de IA
Si lees la documentación de los propios operadores, los crawlers caen en tres grupos.
Crawlers de búsqueda: si te pueden citar
Indexan páginas para que un asistente las encuentre cuando busca durante una conversación. OpenAI dice que los sitios que excluyen a OAI-SearchBot no aparecerán en las respuestas de búsqueda de ChatGPT. Anthropic dice que desactivar Claude-SearchBot puede reducir tu visibilidad en los resultados de búsqueda de Claude. Perplexity dice que PerplexityBot muestra y enlaza sitios en sus respuestas y no se usa para entrenar. meta-webindexer, de Meta, hace el mismo trabajo para Meta AI.
Google y Microsoft no operan crawlers separados para esto. Google dice que AI Overviews y AI Mode usan los mismos controles que la Búsqueda, así que Googlebot es el que importa ahí.
Fetchers de usuario: alguien lo pidió
ChatGPT-User, Claude-User, Perplexity-User y MistralAI-User abren una página porque alguien, en una conversación, preguntó por ella o pegó el enlace. OpenAI dice que las reglas de robots.txt pueden no aplicarse a ChatGPT-User, y Perplexity dice que Perplexity-User por lo general las ignora, porque una persona pidió la página. Anthropic dice que sus crawlers, Claude-User incluido, respetan robots.txt.
Crawlers y tokens de entrenamiento: modelos futuros
GPTBot, ClaudeBot, meta-externalagent y CCBot, de Common Crawl, recogen páginas que pueden usarse para entrenar modelos. Dos entradas de aquí ni siquiera son crawlers. Google-Extended controla si Gemini puede usar páginas que Googlebot ya rastreó, para entrenamiento y para grounding, y Google dice que no afecta a la Búsqueda. Applebot-Extended controla si Apple puede entrenar con lo que Applebot rastreó.
Qué cambia al bloquear cada uno
| Si bloqueas | Qué cambia |
|---|
OAI-SearchBot | Tus páginas no pueden aparecer en las respuestas de búsqueda de ChatGPT |
Claude-SearchBot | La búsqueda de Claude no puede indexar tus páginas |
PerplexityBot | Perplexity no puede mostrar ni enlazar tus páginas |
Googlebot | Sales de la Búsqueda de Google, incluidos AI Overviews y AI Mode |
GPTBot, ClaudeBot | Tu contenido queda fuera del entrenamiento futuro. Las respuestas de búsqueda en vivo no se ven afectadas |
Google-Extended | Gemini no puede entrenar con tus páginas ni basar respuestas en ellas. La Búsqueda de Google no se ve afectada |
CCBot | Las páginas nuevas quedan fuera de Common Crawl, con el que se entrenan muchos modelos |
De la documentación de cada operador, leída el 24 de octubre de 2026: OpenAI, Anthropic, Perplexity, Google, Meta, Apple, Common Crawl.
Un robots.txt para un sitio B2B que quiere que lo citen
Esto permite todos los crawlers de búsqueda y de respuestas, mantiene privadas tus rutas privadas y deja explícita la decisión sobre el entrenamiento. Borra el último grupo si te parece bien que tus páginas públicas se usen para entrenar.
# Everyone: crawl the public site, not the app
User-agent: *
Disallow: /app/
Disallow: /admin/

# AI search and answer crawlers: same rules, named so nobody
# "tidies" them into a block later
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: meta-webindexer
Disallow: /app/
Disallow: /admin/

# Training: opt out (optional)
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
Disallow: /

Sitemap: https://www.example.com/sitemap.xml
Una regla confunde a mucha gente: un crawler solo sigue el grupo que lo nombra. Si le das a OAI-SearchBot su propio grupo, ignora todo lo que esté bajo User-agent: *, así que las rutas privadas hay que repetirlas, como arriba.
Errores comunes
- Un robots.txt de staging en producción.
User-agent: * / Disallow: / bloquea a todos los crawlers que cumplen las reglas, incluidos los de búsqueda.
- Una página de inicio servida como robots.txt. Las aplicaciones de una sola página suelen responder con la app a cualquier ruta desconocida. Los crawlers la leen, no encuentran reglas y permiten todo, incluso lo que querías bloquear.
- Un robots.txt que da error. El RFC 9309 dice que un crawler que recibe un error de servidor debe tratar todo el sitio como bloqueado hasta que el archivo cargue.
- Bloquear GPTBot para “quedar fuera de ChatGPT”. Eso excluye del entrenamiento. OAI-SearchBot es el que decide la búsqueda de ChatGPT.
- Un firewall que bloquea lo que robots.txt permite. La protección contra bots de un CDN puede rechazar a los crawlers de IA antes de que lean nada. Si tu robots.txt responde a los crawlers con un 403, esa es la causa probable.
El verificador de crawlers de IA lee tu robots.txt como dice el RFC que debe hacerlo un crawler y muestra el veredicto para 18 crawlers, con la línea que decidió cada uno.
Ser rastreable no es ser recomendado
Dejar entrar a los crawlers de búsqueda te hace elegible para que te citen. No hace que un asistente te elija cuando un comprador pide una lista corta. Eso depende de lo que el modelo ya sabe de tu categoría, de qué fuentes considera fiables y de si tus páginas responden la pregunta que se hizo. El siguiente paso es averiguar qué dicen hoy ChatGPT, Claude y Gemini. Mira la guía para que te mencionen para ver qué lo mueve.
Preguntas
¿Debería una empresa B2B bloquear los crawlers de IA?
Normalmente no los de búsqueda. OAI-SearchBot, Claude-SearchBot y PerplexityBot deciden si esos asistentes pueden encontrar y citar tus páginas cuando buscan. Bloquear crawlers de entrenamiento como GPTBot y ClaudeBot es una decisión aparte sobre si tu contenido se usa para entrenar modelos futuros, y no te saca de las respuestas en vivo.
¿Bloquear Google-Extended me saca de AI Overviews?
No. Google dice que Google-Extended no afecta a la Búsqueda de Google, y AI Overviews y AI Mode son parte de la Búsqueda. Siguen las reglas de robots.txt de Googlebot y los controles noindex y nosnippet.
¿Cuánto tarda en aplicarse un cambio en robots.txt?
Depende del operador. Meta dice que sus crawlers pueden guardar robots.txt en caché hasta 24 horas, Amazon dice que unas 24 horas y DuckDuckGo dice 72 horas para DuckAssistBot. Cuenta con unos días.
¿Basta con robots.txt para bloquear un crawler?
Para los crawlers que lo siguen, sí. Es una petición, no un candado: algunos fetchers activados por el usuario dicen que pueden no seguirlo, y robots.txt no frena a nada que ignore el estándar. Las reglas de firewall y CDN son la herramienta para hacerlo cumplir.
Haz una revisión gratis Revisa tu robots.txt →