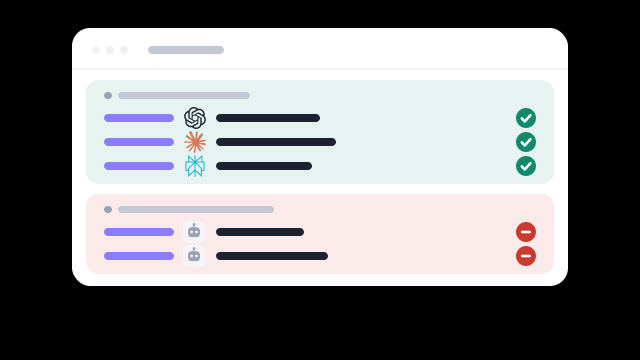
A resposta curta. Se você quer ser recomendado por assistentes de IA, permita os crawlers de busca deles: OAI-SearchBot para o ChatGPT, Claude-SearchBot para o Claude, PerplexityBot para o Perplexity, e Googlebot e Bingbot para os buscadores nos quais os assistentes se baseiam. Permitir ou não também os crawlers de treinamento, como GPTBot e ClaudeBot, é outra escolha, sobre os modelos futuros. Ela não decide se você pode ser citado hoje.
Três tipos de crawler de IA
Lendo a documentação dos próprios operadores, os crawlers se dividem em três grupos.
Crawlers de busca: se você pode ser citado
Esses crawlers indexam páginas para que o assistente as encontre quando pesquisa durante uma conversa. A OpenAI diz que sites que bloqueiam o OAI-SearchBot não aparecem nas respostas de busca do ChatGPT. A Anthropic diz que desativar o Claude-SearchBot pode reduzir sua visibilidade nos resultados de busca do Claude. A Perplexity diz que o PerplexityBot exibe e linka sites nas respostas e não é usado para treinamento. O meta-webindexer, da Meta, faz o mesmo trabalho para o Meta AI.
Google e Microsoft não operam crawlers separados para isso. O Google diz que AI Overviews e AI Mode usam os mesmos controles da Busca, então o Googlebot é o que importa ali.
Fetchers de usuário: alguém pediu
ChatGPT-User, Claude-User, Perplexity-User e MistralAI-User abrem uma página porque alguém, numa conversa, perguntou sobre ela ou colou o link. A OpenAI diz que as regras do robots.txt podem não valer para o ChatGPT-User, e a Perplexity diz que o Perplexity-User em geral as ignora, já que uma pessoa pediu a página. A Anthropic diz que seus crawlers, incluindo o Claude-User, respeitam o robots.txt.
Crawlers e tokens de treinamento: modelos futuros
GPTBot, ClaudeBot, meta-externalagent e o CCBot, do Common Crawl, coletam páginas que podem ser usadas para treinar modelos. Duas entradas aqui nem são crawlers. O Google-Extended controla se o Gemini pode usar páginas que o Googlebot já buscou, para treinamento e para grounding, e o Google diz que ele não afeta a Busca. O Applebot-Extended controla se a Apple pode treinar com o que o Applebot buscou.
O que bloquear cada um muda
| Se você bloquear | O que muda |
|---|
OAI-SearchBot | Suas páginas não podem aparecer nas respostas de busca do ChatGPT |
Claude-SearchBot | A busca do Claude não consegue indexar suas páginas |
PerplexityBot | A Perplexity não consegue exibir nem linkar suas páginas |
Googlebot | Você sai da Busca do Google, incluindo AI Overviews e AI Mode |
GPTBot, ClaudeBot | Seu conteúdo fica fora do treinamento futuro. As respostas de busca ao vivo não são afetadas |
Google-Extended | O Gemini não pode treinar com suas páginas nem basear respostas nelas. A Busca do Google não é afetada |
CCBot | Páginas novas ficam fora do Common Crawl, base de treinamento de muitos modelos |
Da documentação de cada operador, lida em 24 de outubro de 2026: OpenAI, Anthropic, Perplexity, Google, Meta, Apple, Common Crawl.
Um robots.txt para um site B2B que quer ser citado
Ele permite todos os crawlers de busca e de resposta, mantém seus caminhos privados privados e deixa explícita a decisão sobre treinamento. Apague o último grupo se você aceita que suas páginas públicas sejam usadas em treinamento.
# Everyone: crawl the public site, not the app
User-agent: *
Disallow: /app/
Disallow: /admin/

# AI search and answer crawlers: same rules, named so nobody
# "tidies" them into a block later
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: meta-webindexer
Disallow: /app/
Disallow: /admin/

# Training: opt out (optional)
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
Disallow: /

Sitemap: https://www.example.com/sitemap.xml
Uma regra pega muita gente: o crawler segue apenas o grupo que o nomeia. Se você dá ao OAI-SearchBot um grupo próprio, ele ignora tudo o que está em User-agent: *, então os caminhos privados precisam ser repetidos, como acima.
Erros comuns
- Um robots.txt de staging em produção.
User-agent: * / Disallow: / bloqueia todo crawler que respeita as regras, inclusive os de busca.
- Uma página inicial servida como robots.txt. Aplicativos de página única muitas vezes respondem a qualquer caminho desconhecido com o app. Os crawlers leem, não encontram regras e permitem tudo, inclusive o que você queria bloquear.
- Um robots.txt que dá erro. A RFC 9309 diz que um crawler que recebe erro de servidor deve tratar o site inteiro como bloqueado até o arquivo carregar.
- Bloquear o GPTBot para “ficar fora do ChatGPT”. Isso exclui você do treinamento. É o OAI-SearchBot que decide a busca do ChatGPT.
- Um firewall que bloqueia o que o robots.txt permite. A proteção contra bots da CDN pode barrar crawlers de IA antes de eles lerem qualquer coisa. Se o seu robots.txt responde aos crawlers com um 403, essa é a causa provável.
O verificador de crawlers de IA lê seu robots.txt como a RFC diz que um crawler deve ler e mostra o veredito para 18 crawlers, com a linha que decidiu cada um.
Ser rastreável não é ser recomendado
Deixar os crawlers de busca entrarem torna você elegível para ser citado. Isso não faz um assistente escolher você quando um comprador pede uma lista de opções. Isso depende do que o modelo já sabe sobre a sua categoria, de quais fontes ele considera confiáveis e de suas páginas responderem à pergunta feita. O próximo passo é descobrir o que ChatGPT, Claude e Gemini dizem hoje. Veja o guia para ser mencionado e o que muda esse resultado.
Perguntas
Uma empresa B2B deve bloquear crawlers de IA?
Em geral, não os de busca. OAI-SearchBot, Claude-SearchBot e PerplexityBot decidem se esses assistentes conseguem encontrar e citar suas páginas quando pesquisam. Bloquear crawlers de treinamento como GPTBot e ClaudeBot é outra decisão, sobre se o seu conteúdo é usado para treinar modelos futuros, e não tira você das respostas ao vivo.
Bloquear o Google-Extended me tira dos AI Overviews?
Não. O Google diz que o Google-Extended não afeta a Busca do Google, e AI Overviews e AI Mode fazem parte da Busca. Eles seguem as regras de robots.txt do Googlebot e os controles noindex e nosnippet.
Quanto tempo leva para uma mudança no robots.txt valer?
Depende do operador. A Meta diz que seus crawlers podem manter o robots.txt em cache por até 24 horas, a Amazon diz cerca de 24 horas, e o DuckDuckGo diz 72 horas para o DuckAssistBot. Conte com alguns dias.
O robots.txt basta para bloquear um crawler?
Para os crawlers que o seguem, sim. É um pedido, não uma tranca: alguns fetchers acionados pelo usuário dizem que podem não segui-lo, e o que ignora o padrão não é barrado por ele. Regras de firewall e de CDN são a ferramenta para impor o bloqueio.
Fazer uma verificação gratuita Verifique seu robots.txt →