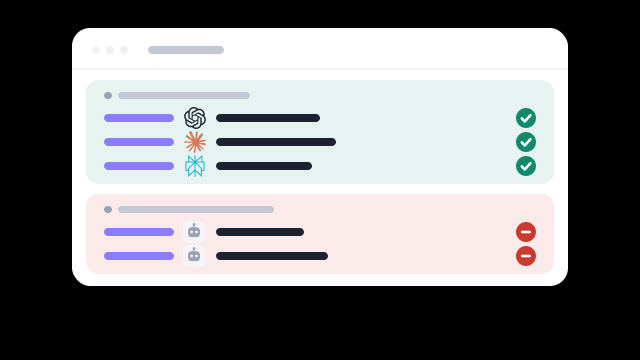
La risposta breve. Se vuoi essere consigliato dagli assistenti AI, consenti i loro crawler di ricerca: OAI-SearchBot per ChatGPT, Claude-SearchBot per Claude, PerplexityBot per Perplexity, e Googlebot e Bingbot per i motori di ricerca a cui gli assistenti attingono. Consentire anche i crawler di addestramento, come GPTBot e ClaudeBot, è una scelta separata sui modelli futuri. Non decide se oggi puoi essere citato.
Tre tipi di crawler AI
Leggendo la documentazione ufficiale degli operatori, i crawler si dividono in tre gruppi.
Crawler di ricerca: decidono se puoi essere citato
Indicizzano le pagine in modo che un assistente possa trovarle quando cerca durante una conversazione. OpenAI dice che i siti che escludono OAI-SearchBot non compaiono nelle risposte di ricerca di ChatGPT. Anthropic dice che disattivare Claude-SearchBot può ridurre la tua visibilità nei risultati di ricerca di Claude. Perplexity dice che PerplexityBot mostra i siti e li linka nelle sue risposte e non viene usato per l'addestramento. meta-webindexer di Meta fa lo stesso lavoro per Meta AI.
Google e Microsoft non gestiscono crawler separati per questo. Google dice che AI Overviews e AI Mode usano gli stessi controlli della Ricerca, quindi lì conta Googlebot.
Fetcher dell'utente: l'ha chiesto una persona
ChatGPT-User, Claude-User, Perplexity-User e MistralAI-User aprono una pagina perché qualcuno, in una conversazione, l'ha chiesta o ha incollato il link. OpenAI dice che le regole di robots.txt potrebbero non valere per ChatGPT-User, e Perplexity dice che Perplexity-User di solito le ignora, dato che la pagina l'ha richiesta una persona. Anthropic dice che i suoi crawler, Claude-User compreso, rispettano robots.txt.
Crawler e token di addestramento: i modelli futuri
GPTBot, ClaudeBot, meta-externalagent e CCBot di Common Crawl raccolgono pagine che possono essere usate per addestrare modelli. Due voci qui non sono affatto crawler. Google-Extended controlla se Gemini può usare pagine che Googlebot ha già recuperato, per l'addestramento e per il grounding, e Google dice che non ha effetto sulla Ricerca. Applebot-Extended controlla se Apple può addestrare modelli su ciò che Applebot ha recuperato.
Cosa cambia bloccando ciascuno
| Se blocchi | Cosa cambia |
|---|
OAI-SearchBot | Le tue pagine non possono comparire nelle risposte di ricerca di ChatGPT |
Claude-SearchBot | La ricerca di Claude non può indicizzare le tue pagine |
PerplexityBot | Perplexity non può mostrare e linkare le tue pagine |
Googlebot | Esci da Google Search, compresi AI Overviews e AI Mode |
GPTBot, ClaudeBot | I tuoi contenuti sono esclusi dall'addestramento futuro. Le risposte di ricerca live non sono toccate |
Google-Extended | Gemini non può addestrarsi sulle tue pagine né basare le risposte su di esse. Google Search non è toccato |
CCBot | Le pagine nuove restano fuori da Common Crawl, su cui sono addestrati molti modelli |
Dalla documentazione di ogni operatore, letta il 24 ottobre 2026: OpenAI, Anthropic, Perplexity, Google, Meta, Apple, Common Crawl.
Un robots.txt per un sito B2B che vuole essere citato
Consente ogni crawler di ricerca e di risposta, mantiene privati i tuoi percorsi privati e lascia esplicita la decisione sull'addestramento. Elimina l'ultimo gruppo se per te va bene che le pagine pubbliche siano usate per l'addestramento.
# Everyone: crawl the public site, not the app
User-agent: *
Disallow: /app/
Disallow: /admin/

# AI search and answer crawlers: same rules, named so nobody
# "tidies" them into a block later
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: meta-webindexer
Disallow: /app/
Disallow: /admin/

# Training: opt out (optional)
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
Disallow: /

Sitemap: https://www.example.com/sitemap.xml
Una regola fa inciampare molti: un crawler segue solo il gruppo che lo nomina. Se dai a OAI-SearchBot un gruppo tutto suo, ignora tutto ciò che sta sotto User-agent: *, quindi i percorsi privati vanno ripetuti, come sopra.
Errori comuni
- Un robots.txt di staging in produzione.
User-agent: * / Disallow: / blocca ogni crawler conforme, compresi quelli di ricerca.
- Una homepage servita come robots.txt. Le single-page app spesso rispondono a ogni percorso sconosciuto con l'app. I crawler la leggono, non trovano regole e consentono tutto, anche ciò che volevi bloccare.
- Un robots.txt che dà errore. RFC 9309 dice che un crawler che riceve un errore del server deve trattare l'intero sito come bloccato finché il file non si carica.
- Bloccare GPTBot per “stare fuori da ChatGPT”. Così escludi l'addestramento. È OAI-SearchBot che decide la ricerca di ChatGPT.
- Un firewall che blocca ciò che robots.txt consente. La protezione anti-bot di una CDN può respingere i crawler AI prima che leggano qualcosa. Se il tuo robots.txt risponde ai crawler con un 403, è probabilmente questa la causa.
L'AI crawler checker legge il tuo robots.txt come dice la RFC che deve fare un crawler e mostra il verdetto per 18 crawler, con la riga che ha deciso per ciascuno.
Essere scansionabili non significa essere consigliati
Far entrare i crawler di ricerca ti rende idoneo a essere citato. Non fa sì che un assistente scelga te quando un acquirente chiede una shortlist. Dipende da ciò che il modello sa già della tua categoria, di quali fonti si fida e dal fatto che le tue pagine rispondano alla domanda posta. Il passo successivo è scoprire cosa dicono oggi ChatGPT, Claude e Gemini. Nella guida per farsi menzionare trovi cosa lo muove.
Domande
Un'azienda B2B dovrebbe bloccare i crawler AI?
Di solito non quelli di ricerca. OAI-SearchBot, Claude-SearchBot e PerplexityBot decidono se quegli assistenti possono trovare e citare le tue pagine quando cercano. Bloccare crawler di addestramento come GPTBot e ClaudeBot è una decisione separata su se i tuoi contenuti vengano usati per addestrare i modelli futuri, e non ti toglie dalle risposte live.
Bloccare Google-Extended mi toglie da AI Overviews?
No. Google dice che Google-Extended non influisce su Google Search, e AI Overviews e AI Mode fanno parte della Ricerca. Seguono le regole robots.txt di Googlebot e i controlli noindex e nosnippet.
Quanto tempo ci mette a essere applicata una modifica a robots.txt?
Dipende dall'operatore. Meta dice che i suoi crawler possono tenere robots.txt in cache fino a 24 ore, Amazon dice circa 24 ore, e DuckDuckGo dice 72 ore per DuckAssistBot. Calcola qualche giorno.
Robots.txt basta per bloccare un crawler?
Per i crawler che lo seguono, sì. È una richiesta, non un lucchetto: alcuni fetcher attivati dall'utente dicono di poterlo non seguire, e ciò che ignora lo standard non viene fermato da robots.txt. Per farlo rispettare servono le regole di firewall e CDN.
Fai un check gratuito Controlla il tuo robots.txt →